
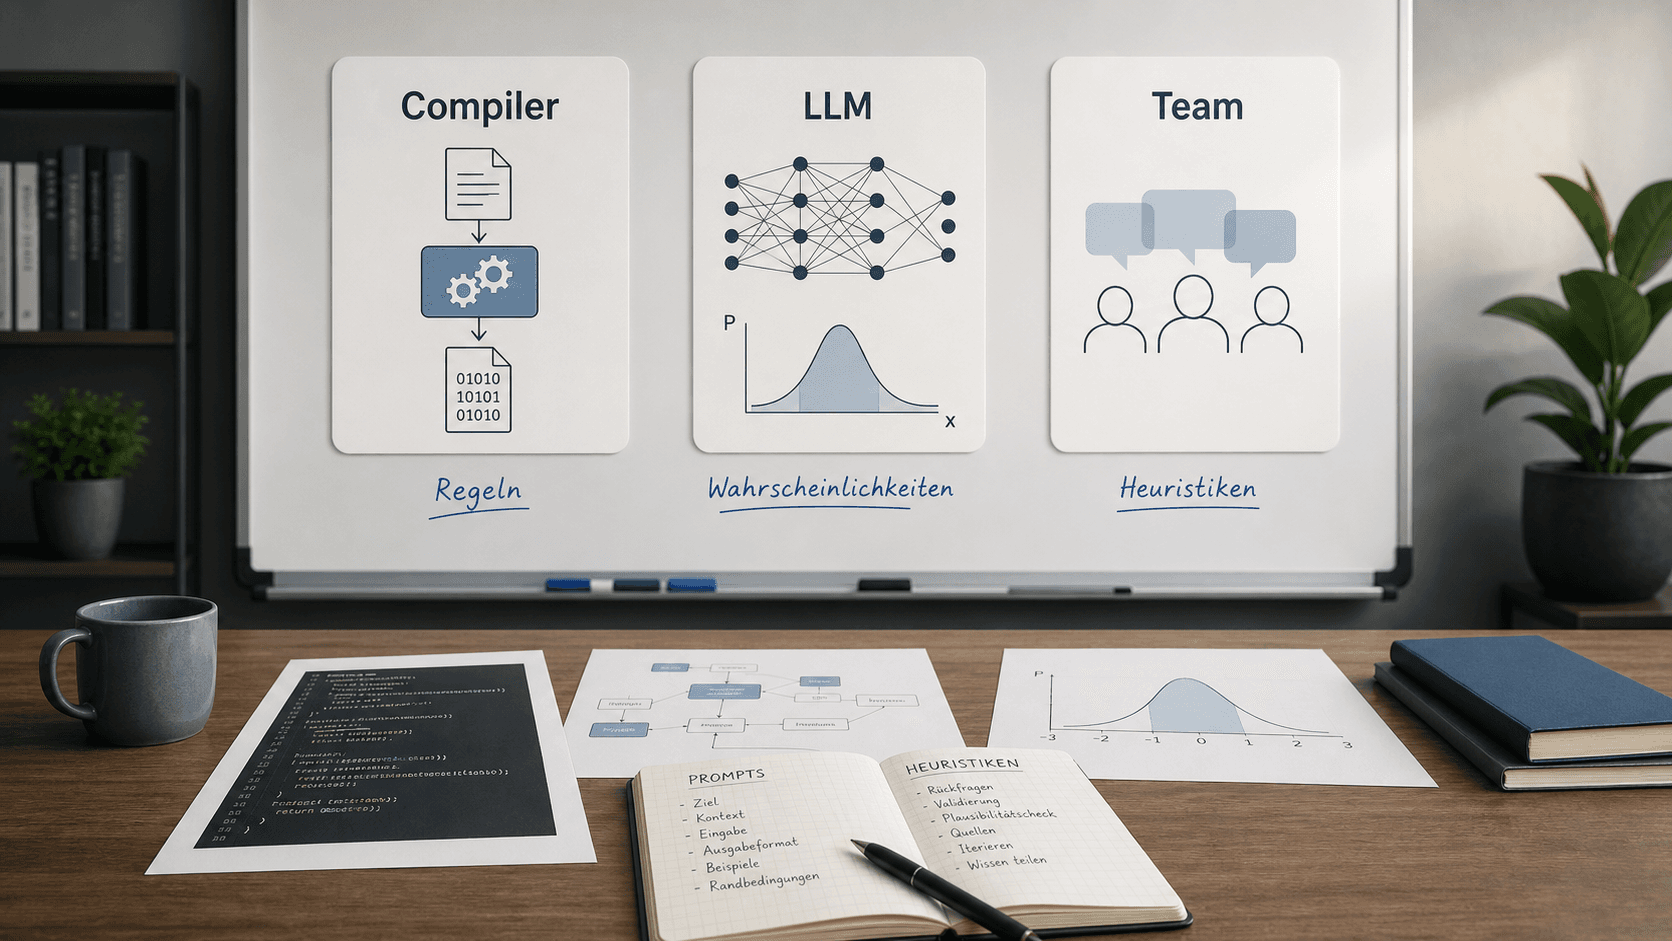
„KI ist der neue Compiler“ ist so ein Satz, der erst einmal schön klingt.
Ich verstehe, warum die Analogie attraktiv ist. Man gibt etwas hinein, im System passiert Verarbeitung, am Ende kommt etwas heraus. Auf dieser sehr abstrakten Ebene passt das. Ein Prompt wirkt dann ein bisschen wie Quellcode. Das Modell wirkt wie eine neue Ausführungsschicht. Und das Ergebnis sieht aus wie etwas, das aus einer technischen Übersetzung entstanden ist.
Je länger ich darüber nachdenke, desto mehr stört mich aber genau diese Abstraktion. Sie beschreibt die Oberfläche. Sie beschreibt nicht das Verhalten.
Und beim Arbeiten mit KI ist Verhalten der entscheidende Punkt.
Ein Compiler entscheidet nicht
Ein Compiler ist ein deterministisches System.
Bei gleichem Input entsteht derselbe Output. Wenn ich denselben Code mit derselben Umgebung, derselben Version und derselben Konfiguration kompiliere, erwarte ich dasselbe Ergebnis. Wenn etwas Unerwartetes passiert, suche ich den Fehler im Input, im Compiler, in der Umgebung oder in meinen Annahmen.
Das ist eine sehr wertvolle Eigenschaft. Sie macht Compiler vertrauenswürdig. Sie macht Build-Systeme prüfbar. Sie macht viele technische Prozesse automatisierbar.
Der Compiler entscheidet nicht. Er folgt Regeln.
Natürlich gibt es in echten technischen Systemen immer Details, Versionen, undefiniertes Verhalten, Plattformunterschiede und Seiteneffekte. Aber das Erwartungsmodell bleibt trotzdem klar: Ich behandle den Compiler als regelgebundenes System. Ich will Reproduzierbarkeit. Ich will deterministisches Verhalten. Ich will Fehler lokalisieren können.
Ein LLM funktioniert anders
Ein LLM fühlt sich an manchen Stellen ähnlich an. Ich gebe Text hinein, das System verarbeitet etwas, und am Ende kommt Text, Code, Struktur oder eine Entscheidungsvorlage heraus.
Der Mechanismus ist aber ein anderer.
Ein LLM arbeitet nicht wie ein Compiler, der feste Regeln auf Quellcode anwendet. Es erzeugt eine plausible Fortsetzung auf Basis gelernter Muster, Kontext, Wahrscheinlichkeiten und Modellparametern. Der gleiche Prompt kann ähnliche Ergebnisse erzeugen, aber nicht zwingend identische. Selbst wenn die Ausgabe stabil wirkt, bleibt das innere Erwartungsmodell ein anderes.
Das ist keine Schwäche, die man einfach wegoptimiert. Es ist ein anderer Modus.
- Bei einem Compiler frage ich: Ist die Übersetzung korrekt?
- Bei einem LLM frage ich zusätzlich: Ist das Ergebnis plausibel, hilfreich, vollständig, passend zum Kontext und fachlich tragfähig?
Das sind andere Prüfungsfragen.
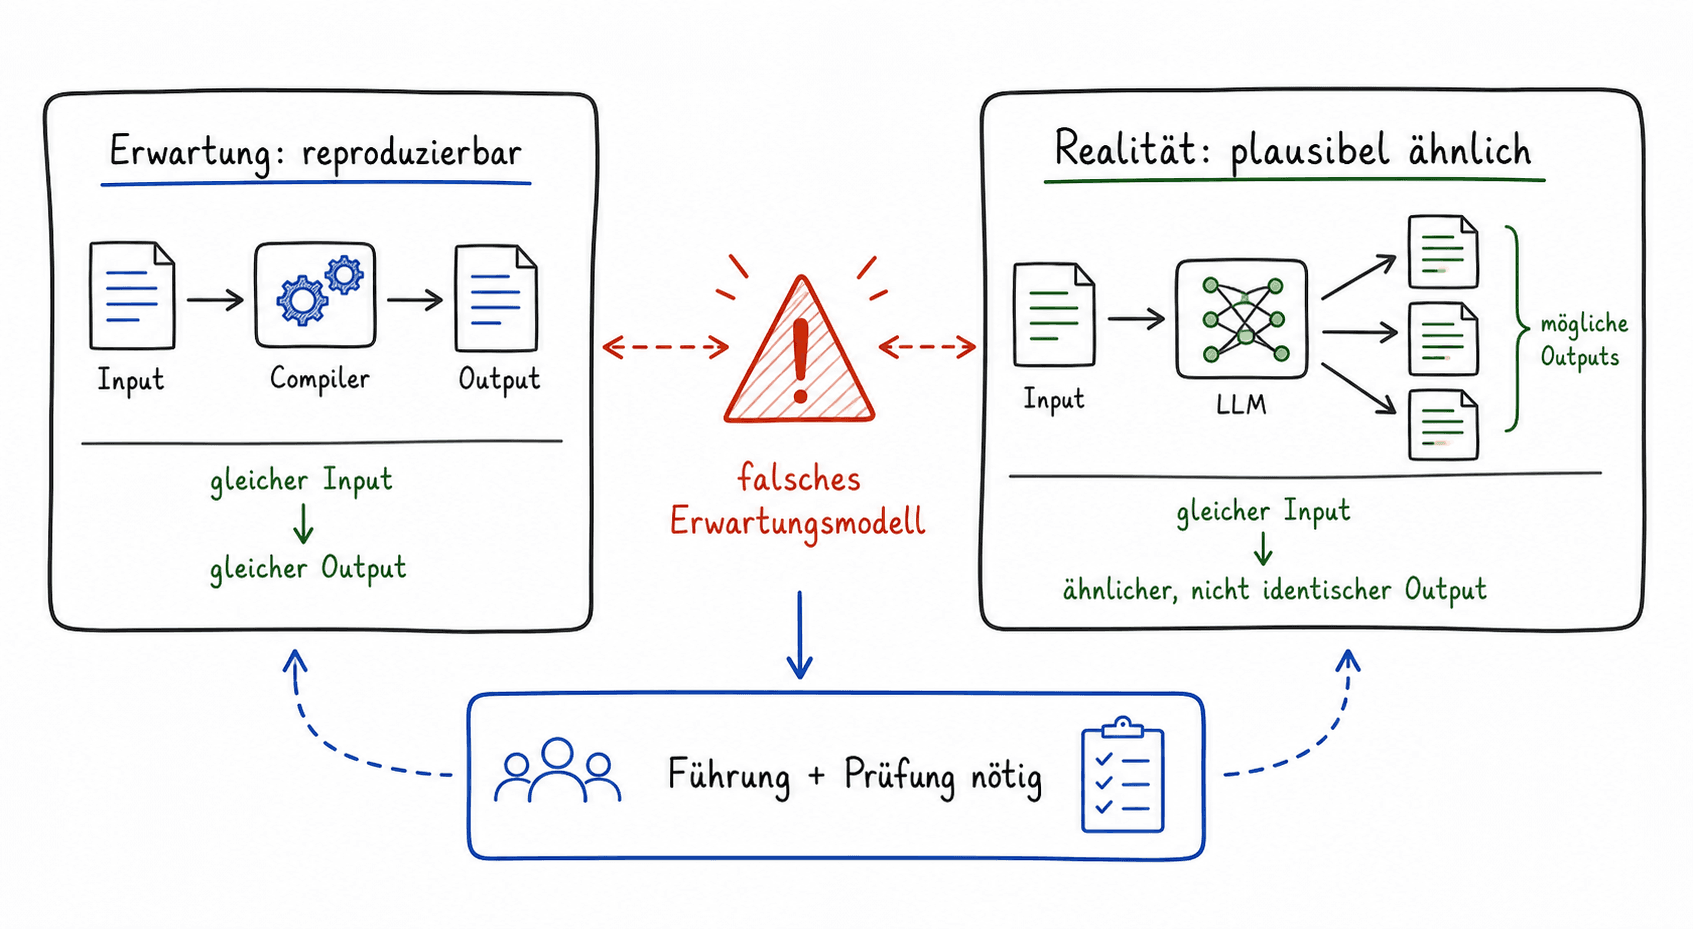
Der Fehler beginnt, wenn wir einem probabilistischen System deterministische Erwartungen geben.
Genau dort entstehen viele Missverständnisse. Wir wollen Reproduzierbarkeit wie bei einem Compiler. KI liefert eher statistische Ähnlichkeit. Das kann extrem nützlich sein. Aber es verlangt eine andere Art von Führung, Prüfung und Vertrauen.
Menschen und Teams sind wieder anders
Dann gibt es noch Menschen, Teams und Organisationen.
Wenn ich einem Team denselben Auftrag zweimal gebe, kann ebenfalls ein anderes Ergebnis entstehen. Das liegt aber nicht daran, dass das Team im mathematischen Sinn eine Wahrscheinlichkeitsverteilung fortsetzt. Menschen nutzen Erfahrung, Heuristiken, Annahmen, Kontext, Geschmack, Interpretation und manchmal auch Bauchgefühl.
Ein Team kann denselben Input heute anders bewerten als morgen, weil sich Wissen verändert hat. Weil eine Nebenbedingung wichtiger geworden ist. Weil jemand eine neue Erfahrung eingebracht hat. Weil die politische, technische oder fachliche Umgebung nicht mehr dieselbe ist.
Das Verhalten ist nicht deterministisch wie bei einem Compiler. Es ist auch nicht probabilistisch im engen Sinn eines Modells.
Es ist heuristisch.
Das klingt theoretisch, ist aber ziemlich praktisch. Sobald ich Systeme nach ihrem Entscheidungsverhalten betrachte, verändern sich die Erwartungen:
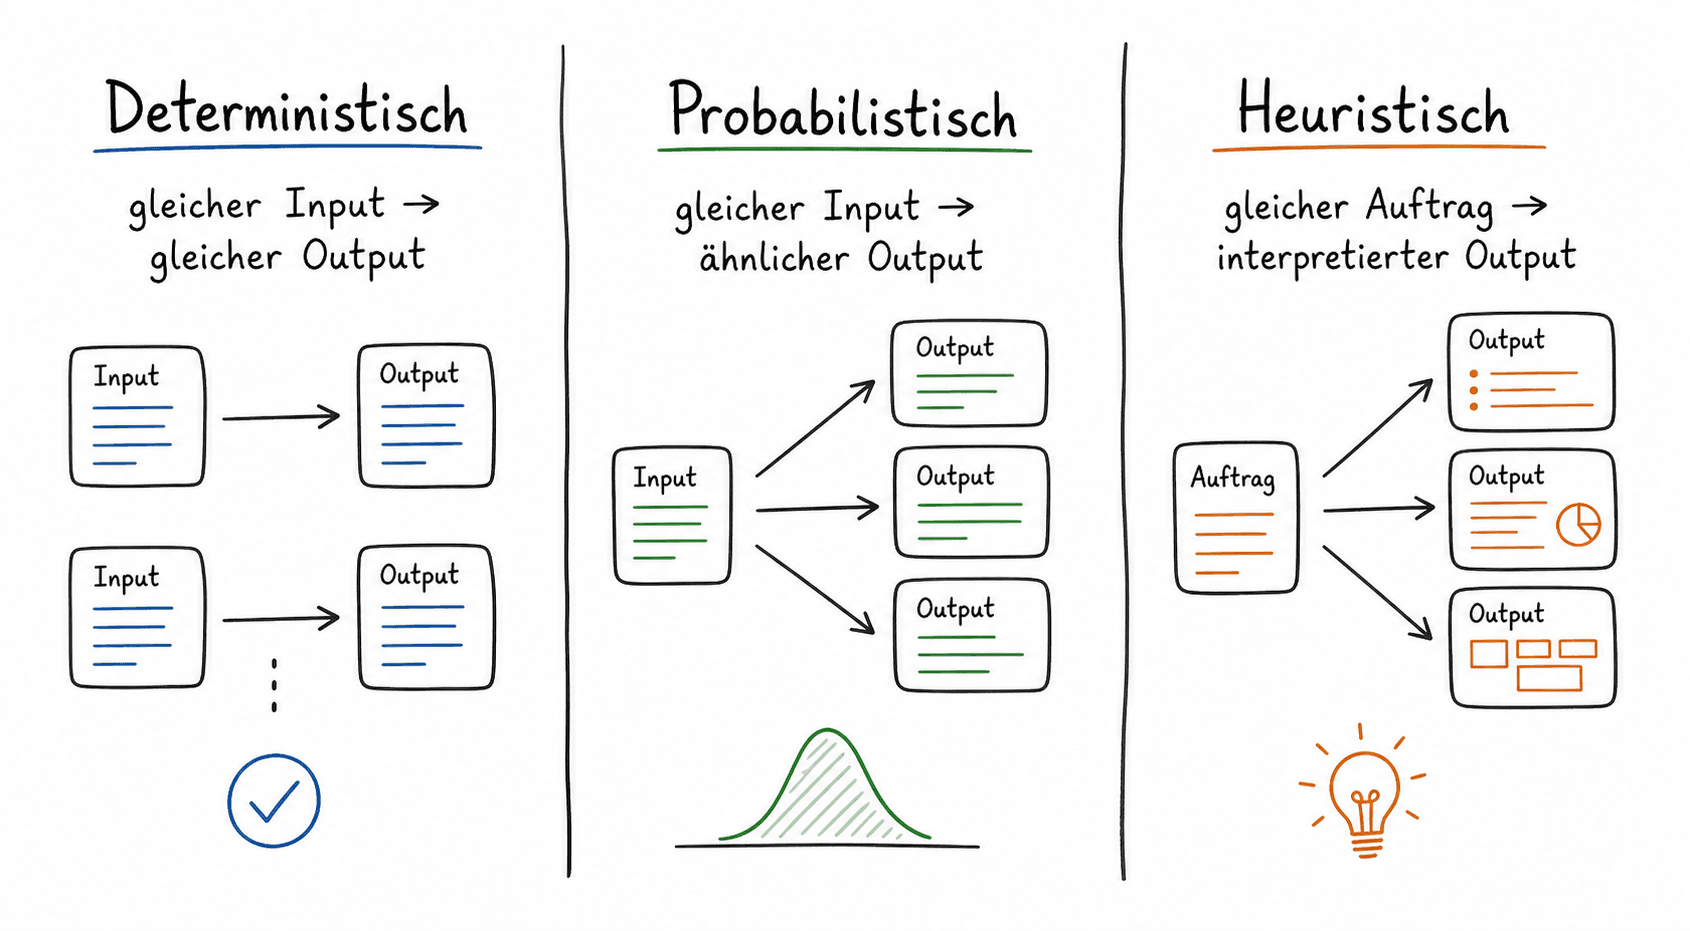
- Deterministische Systeme sollen reproduzierbar sein.
- Probabilistische Systeme müssen geführt und geprüft werden.
- Heuristische Systeme brauchen Kontext, Erfahrung und Urteil.
Diese Unterscheidung hilft mir gerade mehr als die Frage, ob KI „wie ein Compiler“ ist.
Die eigentliche Frage heißt Erwartungsmodell
Vielleicht sollten wir Systeme weniger danach sortieren, wie technisch sie aussehen, und stärker danach, welches Verhalten sie erzeugen.
Ein Compiler ist ein gutes Werkzeug, weil er sich verlässlich an Regeln hält. Ein LLM ist ein gutes Werkzeug, weil es in unscharfen Räumen schnell brauchbare Vorschläge, Strukturen, Varianten und erste Arbeitsstände erzeugen kann. Ein Mensch ist wertvoll, weil er Bedeutung, Kontext, Richtung und Verantwortung zusammenbringen kann.
Diese Fähigkeiten sind nicht austauschbar. Sie ergänzen sich.
Das Problem beginnt, wenn ich die falsche Erwartung an das falsche System lege.
Wenn ich von einem LLM Compiler-Verhalten erwarte, werde ich von Abweichungen genervt sein. Wenn ich von einem Compiler menschliches Urteil erwarte, habe ich das falsche Werkzeug gewählt. Wenn ich von einem Team rein maschinelle Reproduzierbarkeit erwarte, ignoriere ich den Teil der Arbeit, der aus Interpretation und Erfahrung besteht.
Der praktische Punkt ist für mich deshalb nicht: „KI ist der neue Compiler.“
Der praktische Punkt ist: KI ist eine neue Klasse von Problemlösern, und sie braucht ein eigenes Bedienmodell.
Was das für KI-Agenten bedeutet
Diese Unterscheidung wird wichtiger, je mehr KI in echte Arbeitsprozesse eingebaut wird.
Bei einem einfachen Prompt kann ich noch relativ leicht sagen: Das Ergebnis ist gut oder schlecht. Bei Agenten wird es spannender. Ein Agent plant, verändert Dateien, führt Befehle aus, interpretiert Fehler, repariert, schreibt Tests, verschiebt Arbeitsschritte und erzeugt neue Zwischenstände.
Das sieht schnell nach Automatisierung aus. Und an manchen Stellen ist es das auch.
Aber die Frage bleibt:
- Welcher Teil des Prozesses darf deterministisch geprüft werden?
- Welcher Teil ist probabilistische Arbeit?
- Und an welcher Stelle braucht es menschliches Urteil?
Tests, Lints, Typprüfungen, Schemas und Formatregeln passen gut zu deterministischen Erwartungen. Sie sagen ja oder nein. Sie machen Schleifen automatisierbar.
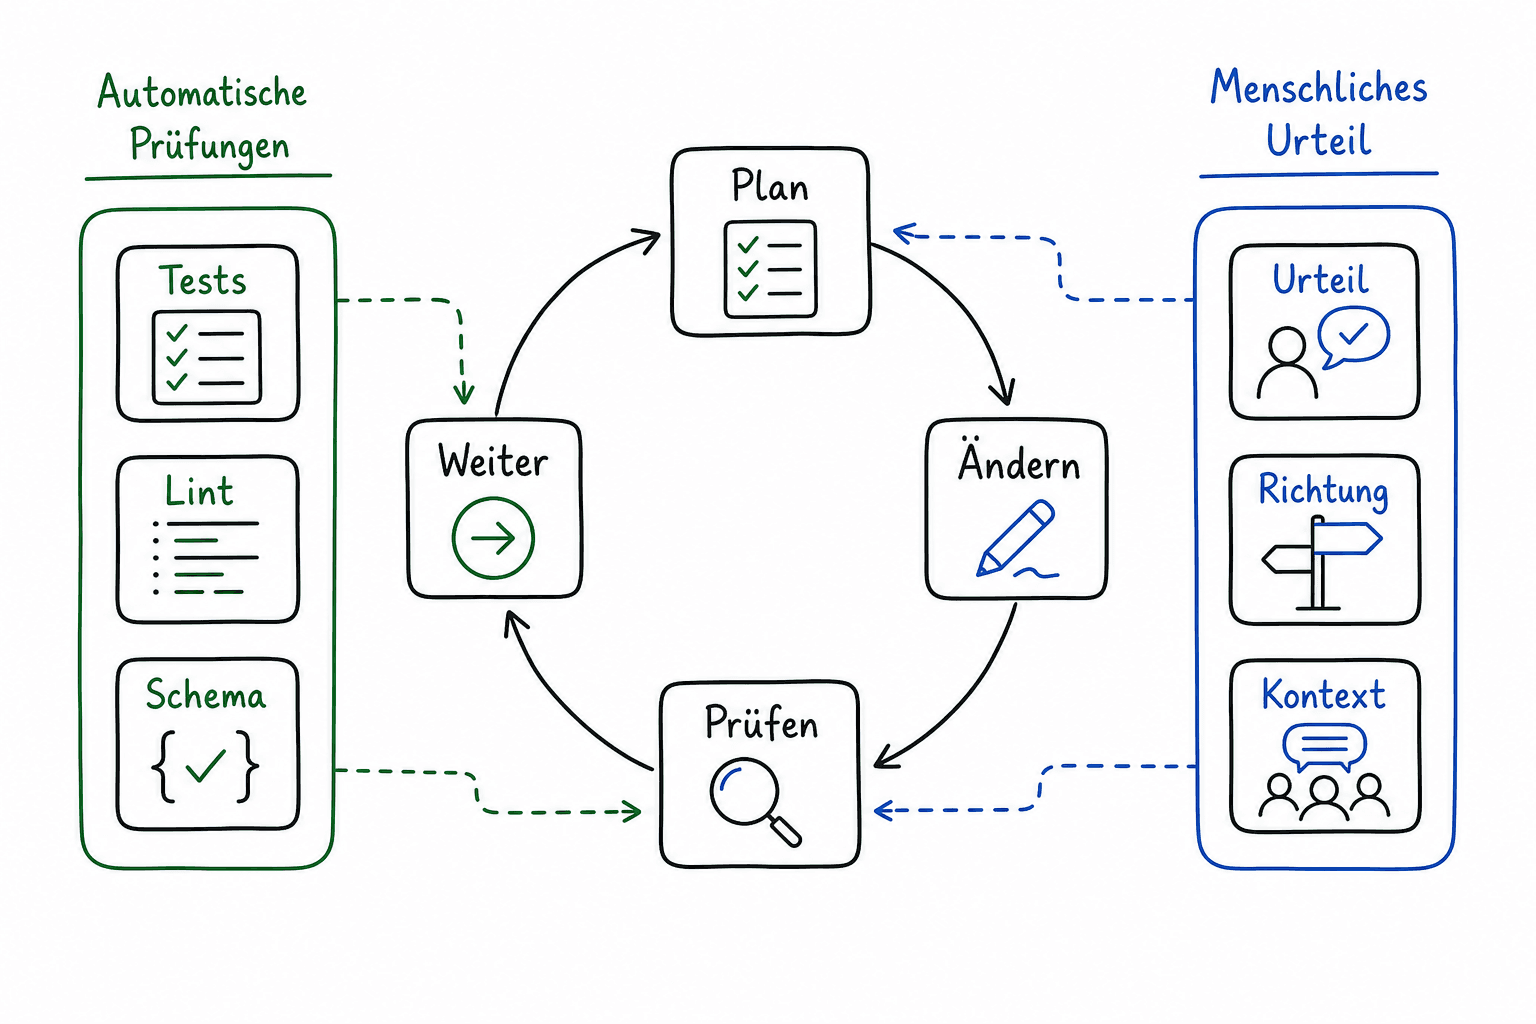
Problemformulierung, Produktentscheidung, Tonalität, Architekturgeschmack, Priorisierung und Sinn für den nächsten Schritt funktionieren anders. Dort reicht es nicht, dass ein Agent „weiterläuft“. Dort muss jemand beurteilen, ob die Richtung noch stimmt.
Dieser Punkt hängt direkt mit der Loop-Frage zusammen. Ich habe das im Artikel A Loop Without Judgment Is Just Faster Repetition ausführlicher beschrieben: Die harte Frage ist nicht, ob ein System iteriert. Die harte Frage ist, wer den neuen Zustand bewertet.
Wenn wir KI-Agenten wie Compiler behandeln, übersehen wir genau diesen Unterschied. Dann erwarten wir eine Art magische Ausführungsschicht, die aus Zielbeschreibung automatisch richtige Arbeit macht.
So fühlt sich gute KI-Arbeit für mich gerade nicht an.
Sie fühlt sich eher wie Zusammenarbeit mit einem probabilistischen Problemlöser an, der sehr schnell sehr viel Bewegung erzeugen kann. Diese Bewegung ist wertvoll. Aber sie braucht Führung, Prüfpunkte und menschliches Urteil.
Die Analogie ist nicht falsch. Sie ist nur zu klein.
Der Satz „KI ist der neue Compiler“ kann ein guter Einstieg sein. Er macht sichtbar, dass Sprache plötzlich ausführbarer wirkt. Er erklärt, warum Prompts, Spezifikationen und Arbeitsanweisungen wichtiger werden. Er zeigt, dass eine neue Übersetzungsschicht entstanden ist.
Für die tägliche Arbeit reicht mir das Bild trotzdem nicht.
- Ein Compiler übersetzt nach Regeln.
- Ein LLM erzeugt plausible Fortsetzungen.
- Menschen und Teams arbeiten mit Heuristiken, Erfahrung und Verantwortung.
Wenn ich diese Unterschiede ernst nehme, wird KI nicht kleiner. Sie wird besser handhabbar.
Ich erwarte dann nicht mehr, dass sie sich wie ein Compiler verhält. Ich baue stattdessen Prozesse, in denen probabilistische Vorschläge, deterministische Prüfungen und menschliches Urteil sinnvoll zusammenspielen.
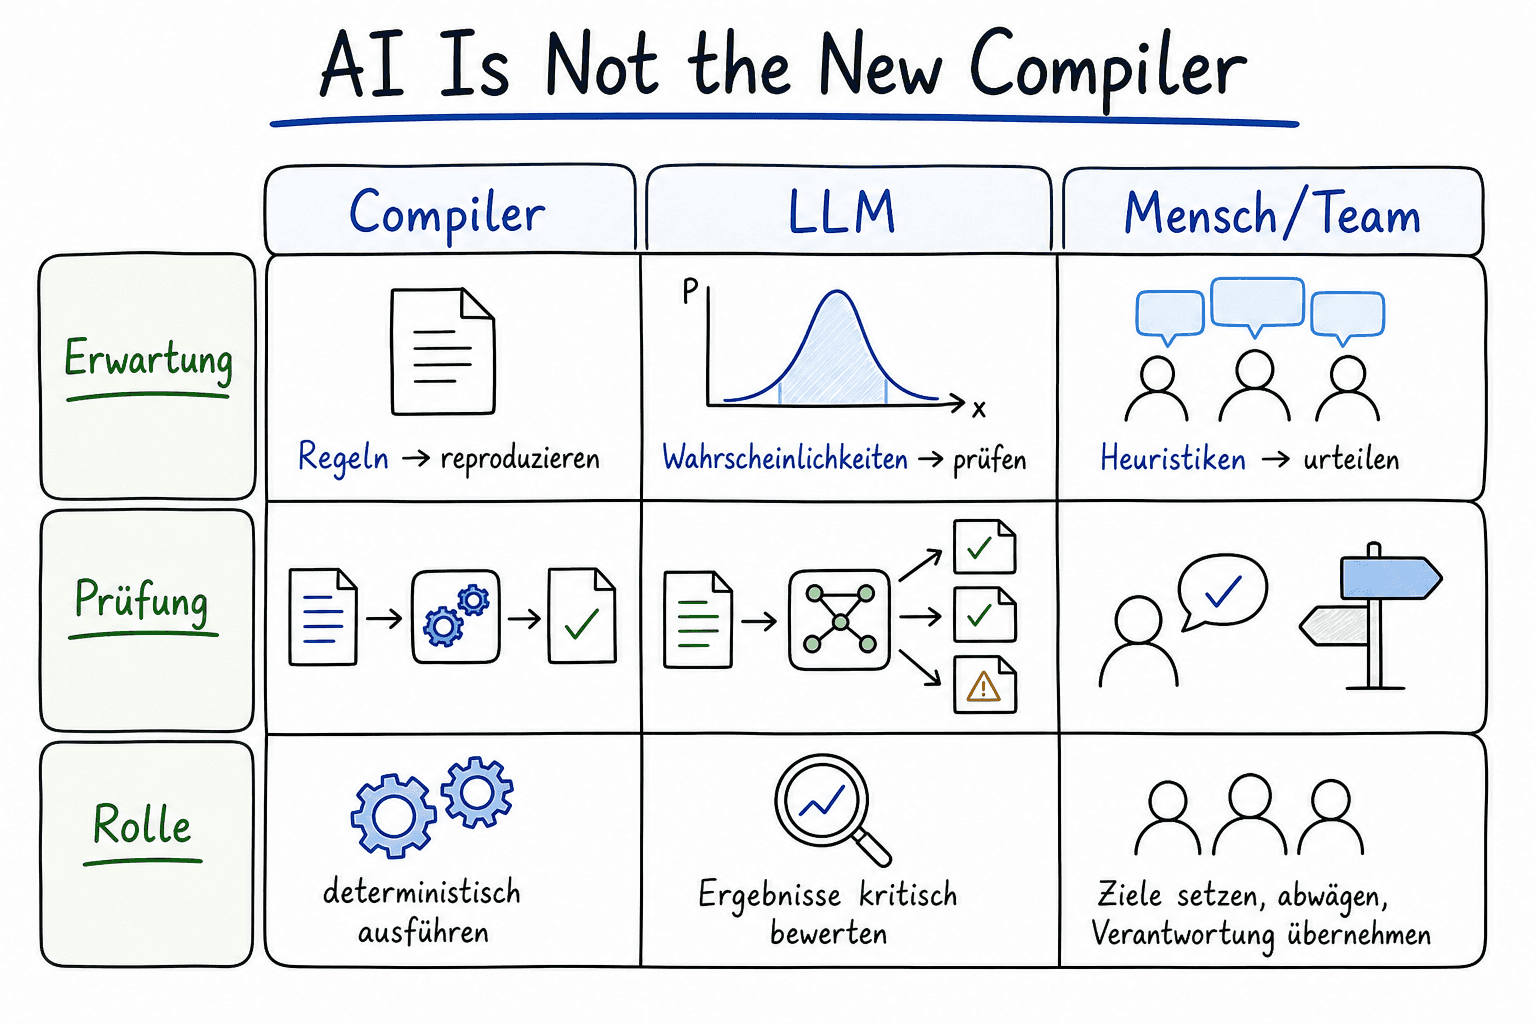
Vielleicht ist das die nützlichere Analogie:
KI ist nicht der neue Compiler. KI ist ein neuer Problemlöser in einem Arbeitsgefüge, das wir erst sauber entwerfen müssen.