
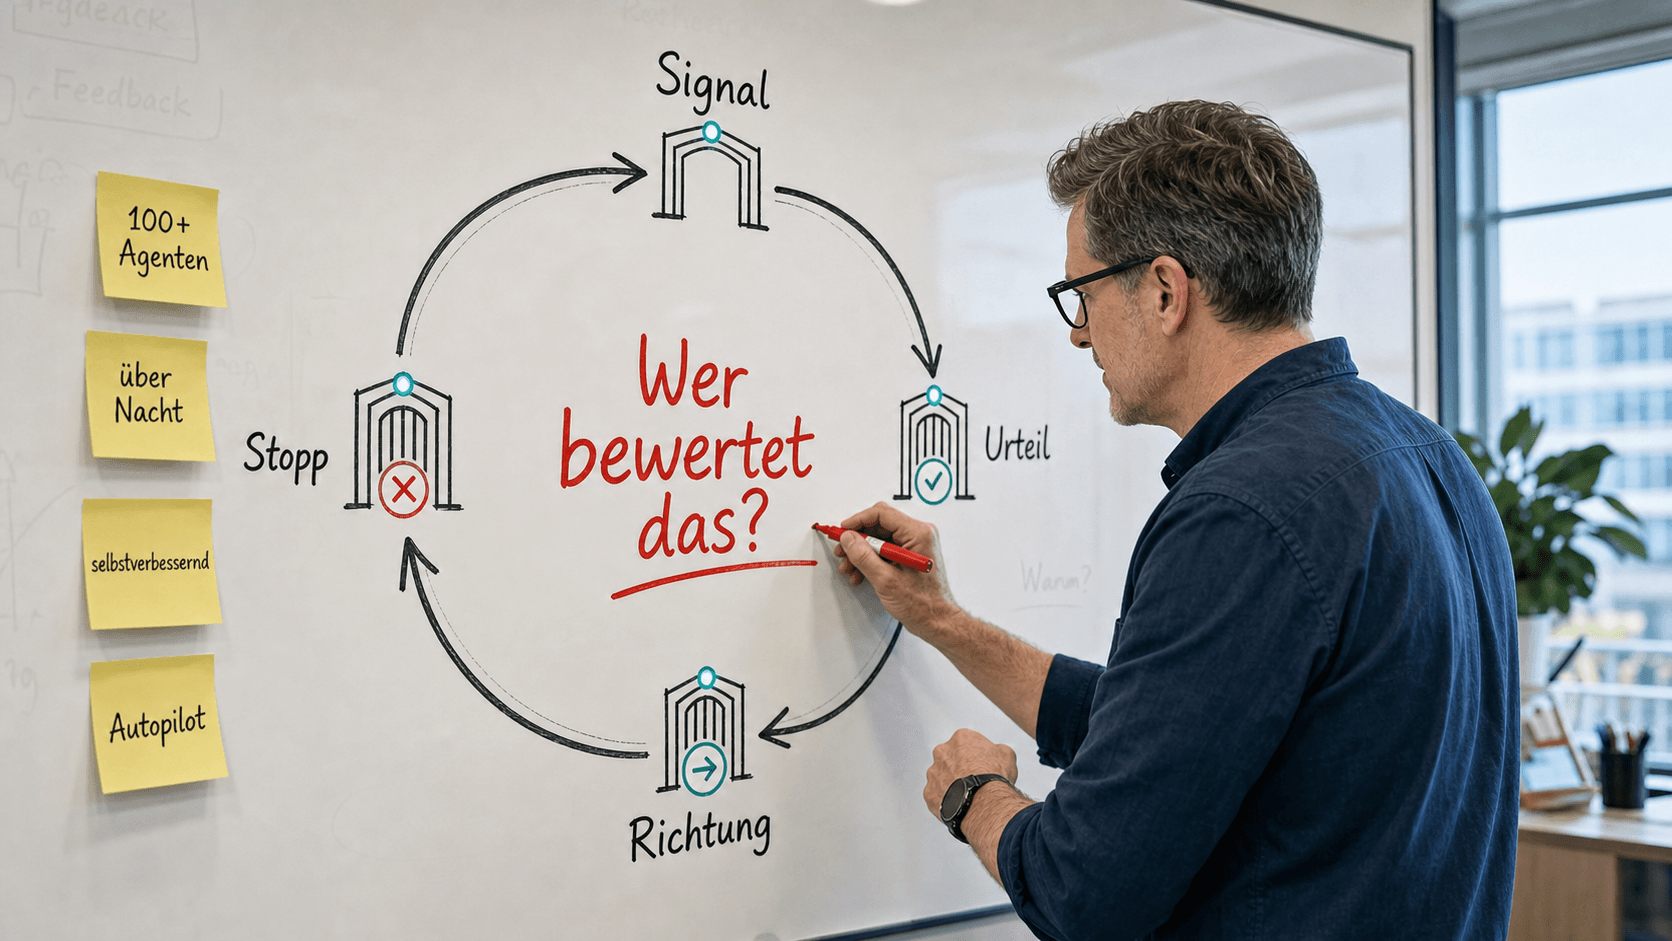
Offenbar haben wir 2026 die Iteration entdeckt.
So fühlt es sich gerade zumindest an, wenn man auf X oder LinkedIn unterwegs ist. Überall tauchen Loops auf. Agent loops. Feedback loops. Self-improving loops. Loop Engineering. Agents, die nachts laufen. Agents, die sich selbst verbessern. Agents, die angeblich nur noch ein Ziel brauchen und dann so lange iterieren, bis irgendetwas fertig ist.
Und ja: Loops sind nützlich. Natürlich sind sie nützlich. Ich arbeite selbst ständig in Schleifen. Beim Schreiben. Beim Bauen. Beim Debuggen. Beim Nachdenken über Produktentscheidungen. Das Problem ist nicht der Loop.
Das Problem ist, dass gerade so getan wird, als hätten wir mit AI Agents plötzlich Iteration erfunden.
Ein Loop ohne Urteil ist nur schnellere Wiederholung.
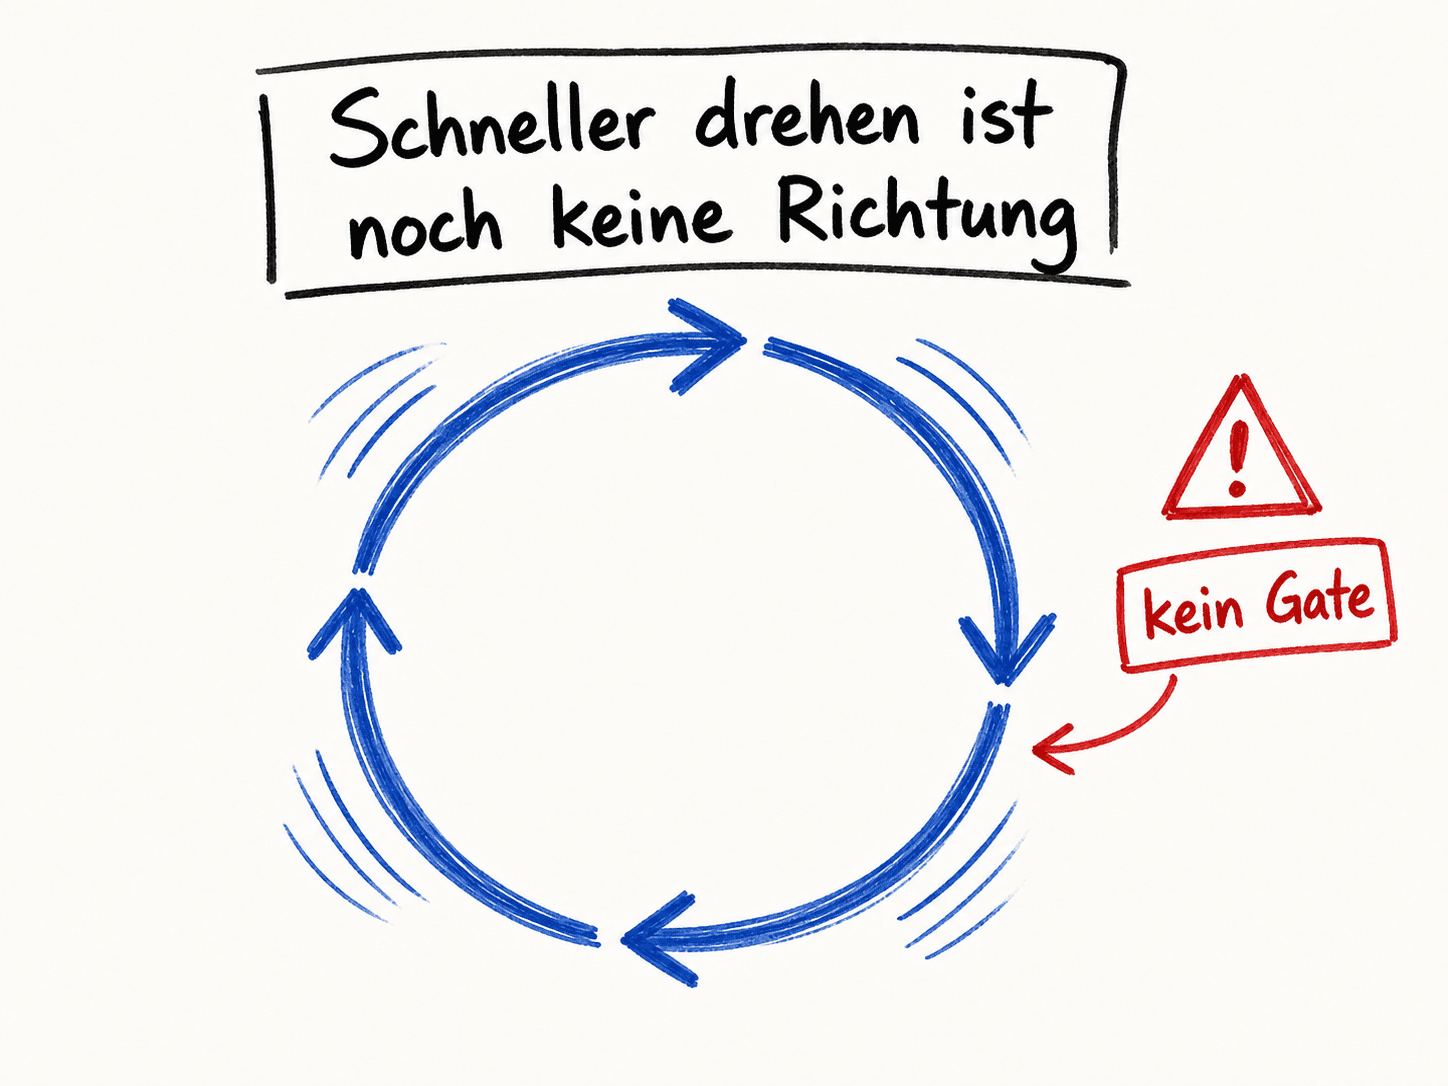
Das ist der Punkt, der mich an diesem Hype nervt. Eine sinnvolle Arbeitslogik wird gerade in ein neues Wunderding verwandelt. Als wäre ein Loop ein Perpetuum mobile. Als würde aus Wiederholung automatisch Richtung entstehen. Als müsste man nur "self-improving" davor schreiben und schon wird aus einer Schleife ein intelligentes Arbeitssystem.
So funktioniert Arbeit aber nicht.
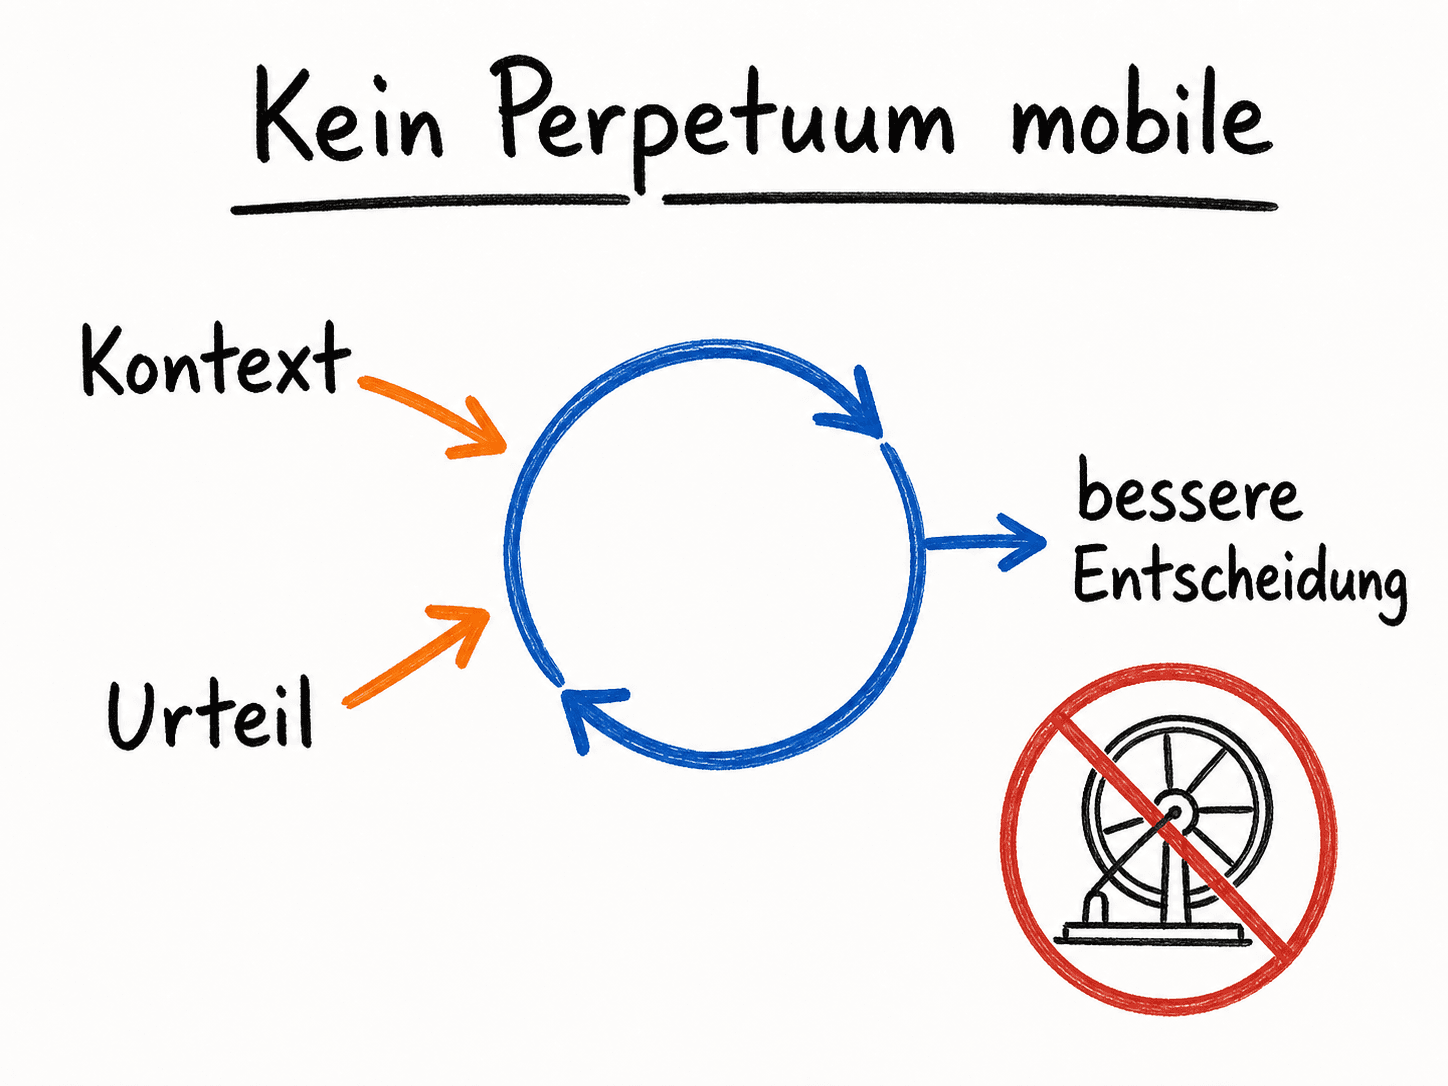
Iteration war nie der neue Teil
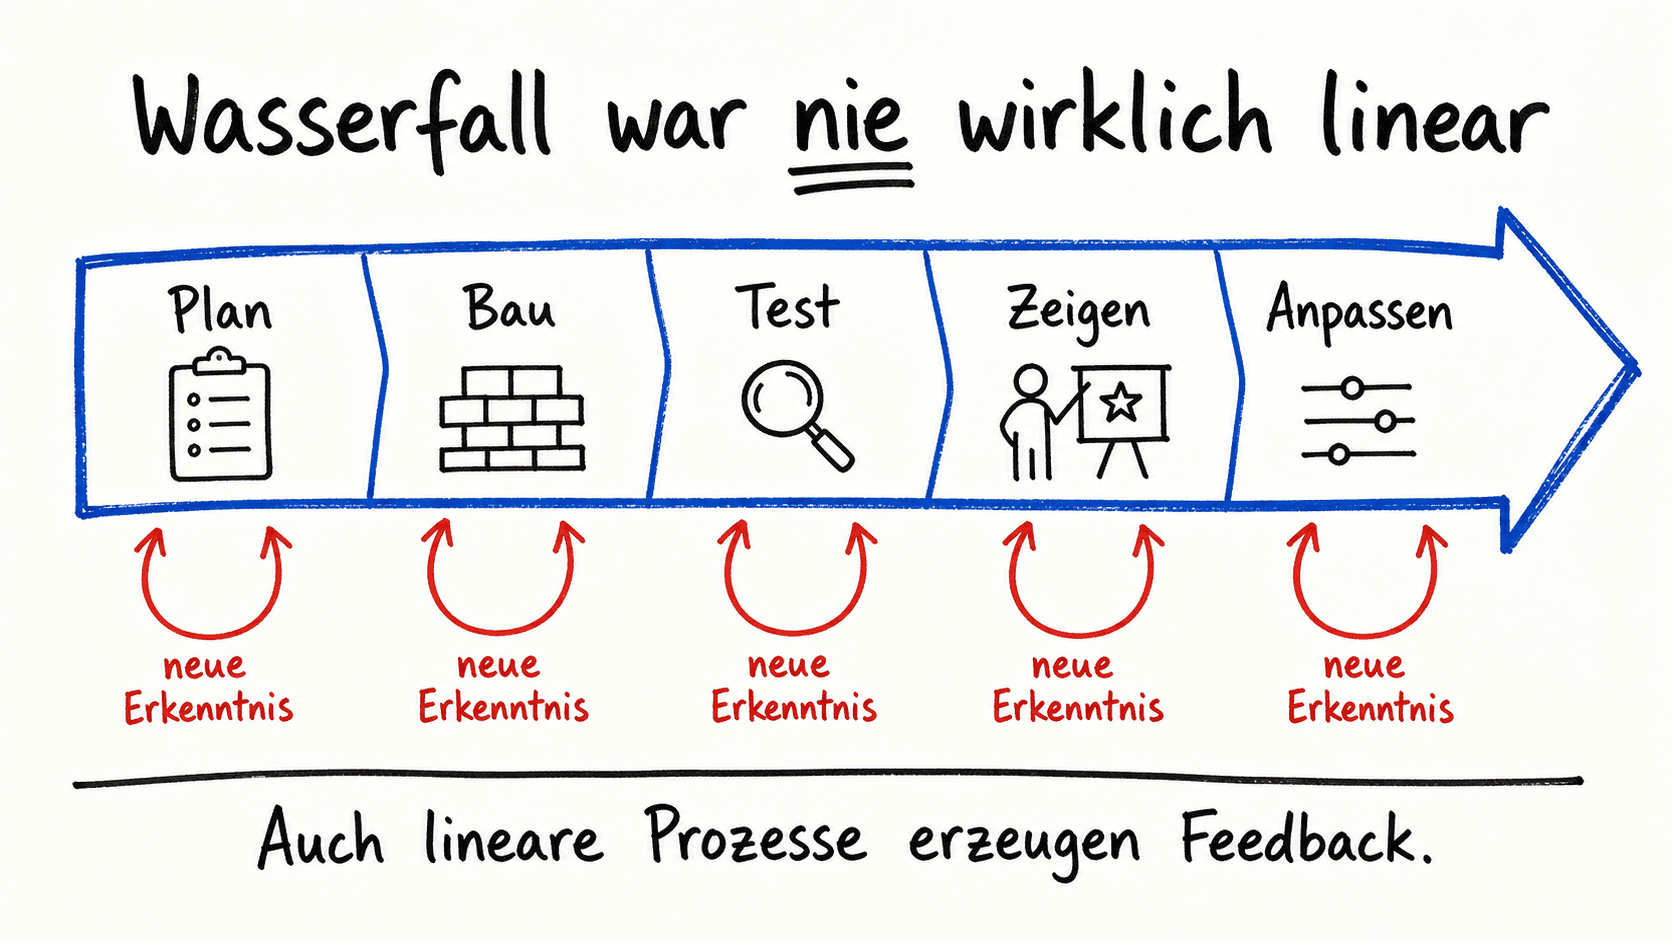
Menschen arbeiten iterativ, seit sie arbeiten. Auch in Organisationen, die offiziell Wasserfall-Prozesse beschrieben haben, wurde iteriert. Nicht unbedingt schön. Nicht unbedingt explizit. Nicht immer mit guten Feedback-Zyklen. Aber natürlich wurde nach jedem Schritt neu bewertet.
Man schreibt eine Spezifikation und merkt beim Erklären, dass ein Begriff nicht trägt. Man baut einen ersten Screen und sieht sofort, dass die Informationshierarchie nicht funktioniert. Man implementiert eine Funktion und merkt beim Testen, dass die eigentliche Produktfrage woanders liegt. Man zeigt einem Kunden einen Zwischenstand und hört diesen sehr speziellen Satz: "Ja, so meinte ich das nicht."
Das ist keine moderne Agenten-Erkenntnis. Das ist die Grundbewegung jeder ernsthaften Arbeit.
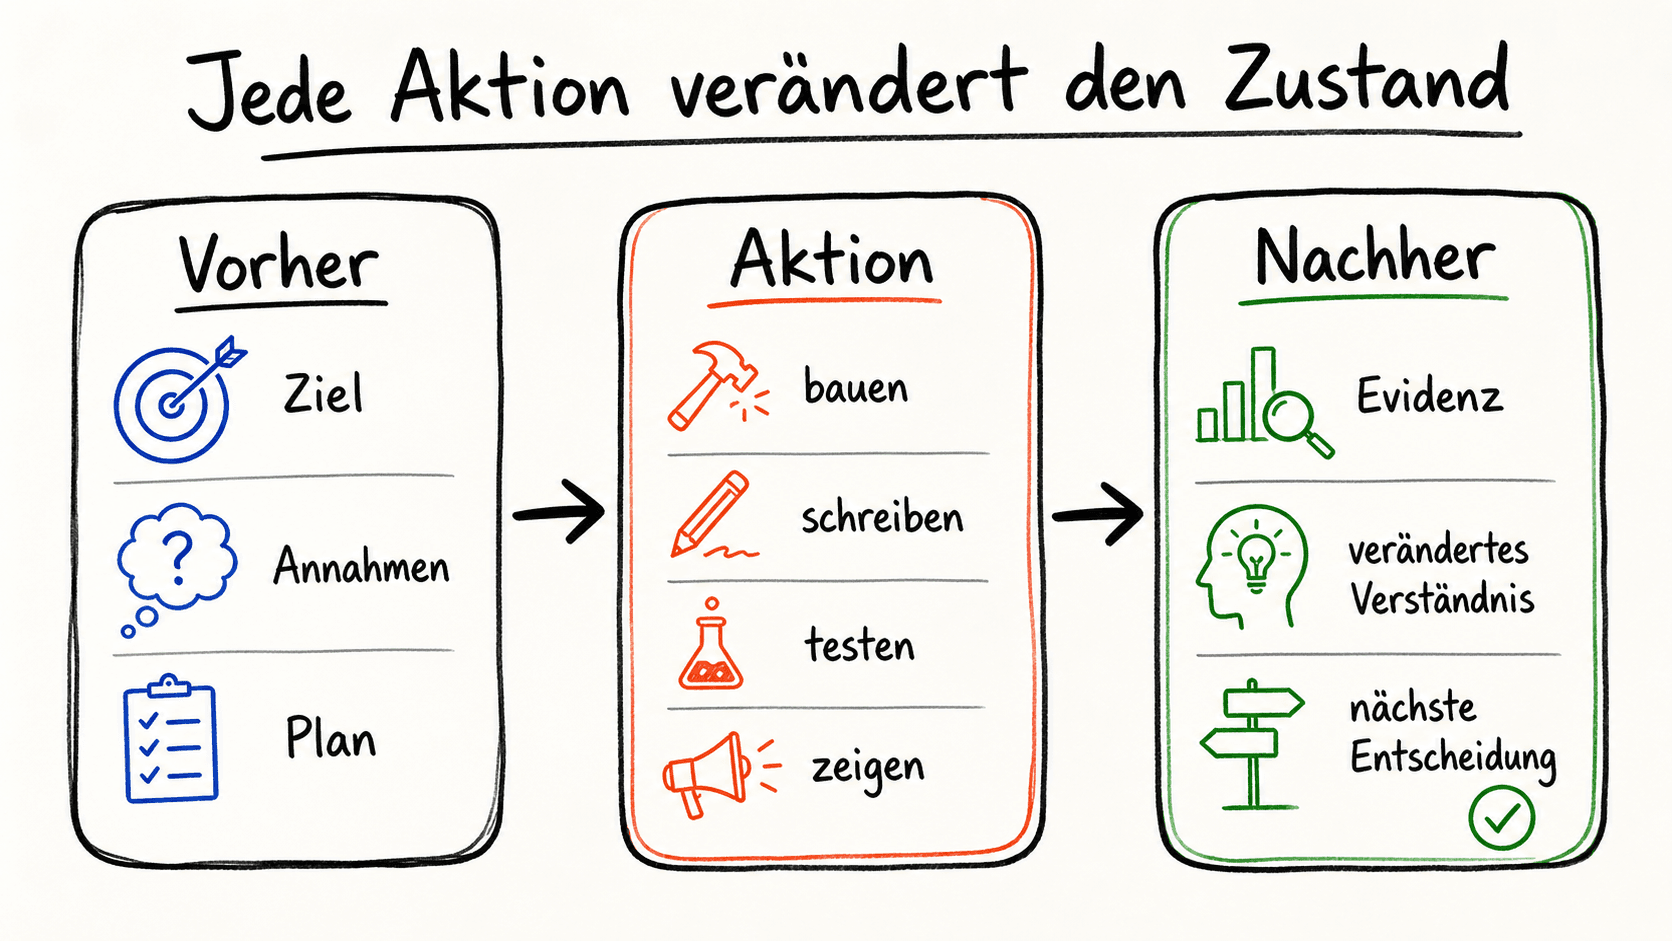
Eine Handlung verändert den Zustand. Der neue Zustand verändert den Erkenntnisstand. Der neue Erkenntnisstand verändert den nächsten Schritt.
Manchmal verändert er nur eine Kleinigkeit. Manchmal verändert er den Weg. Manchmal verändert er sogar die Zielausprägung. Und manchmal merkt man erst am Zwischenergebnis, dass das Ziel selbst falsch beschrieben war.
Iteration ist keine Methode. Sie ist das, was passiert, wenn die Realität antwortet.
Darum greift die aktuelle Loop-Rhetorik oft zu kurz. Sie beschreibt die Wiederholung, aber nicht die Bewertung. Sie zeigt den Kreis, aber nicht das Urteil, das den nächsten Schritt bestimmt.
Der wichtige Teil ist nicht die Schleife
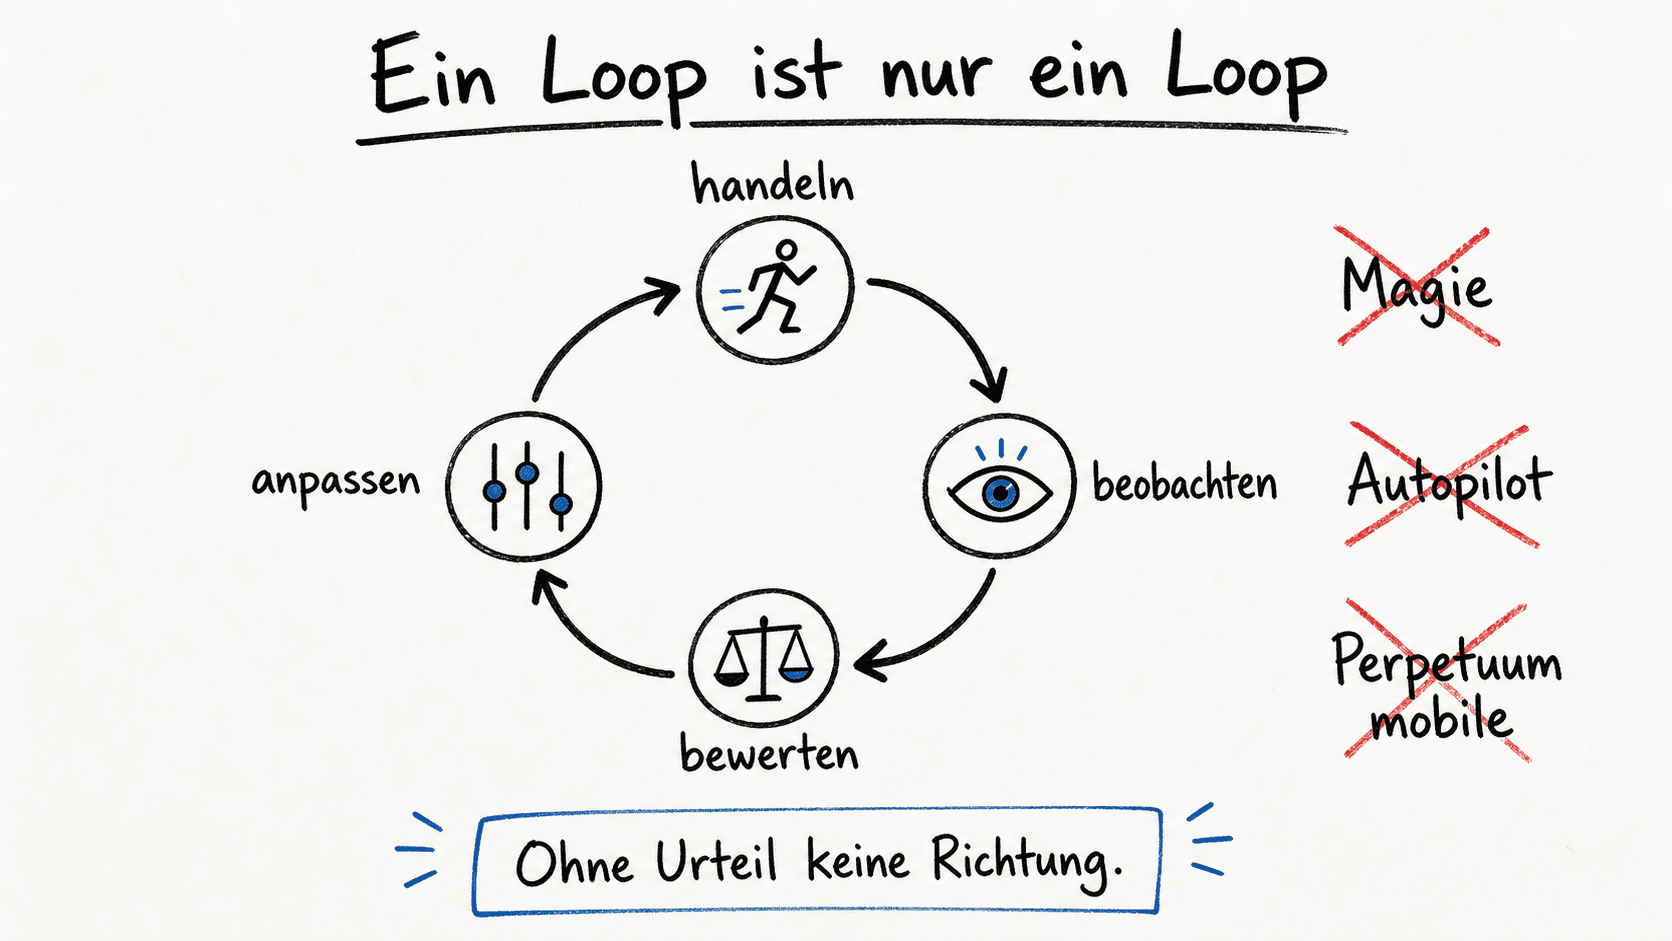
Ein Loop besteht nicht einfach aus "mach das noch mal". Ein sinnvoller Loop hat mindestens vier Teile:
- handeln
- wahrnehmen
- bewerten
- anpassen.
Der Hype redet gerne über das Handeln und Wiederholen. Ein Agent bekommt ein Ziel. Der Agent erzeugt Output. Der Agent prüft den Output. Der Agent repariert den Output. Der Agent läuft weiter. Das klingt sauber. Und in manchen Fällen ist es das auch.
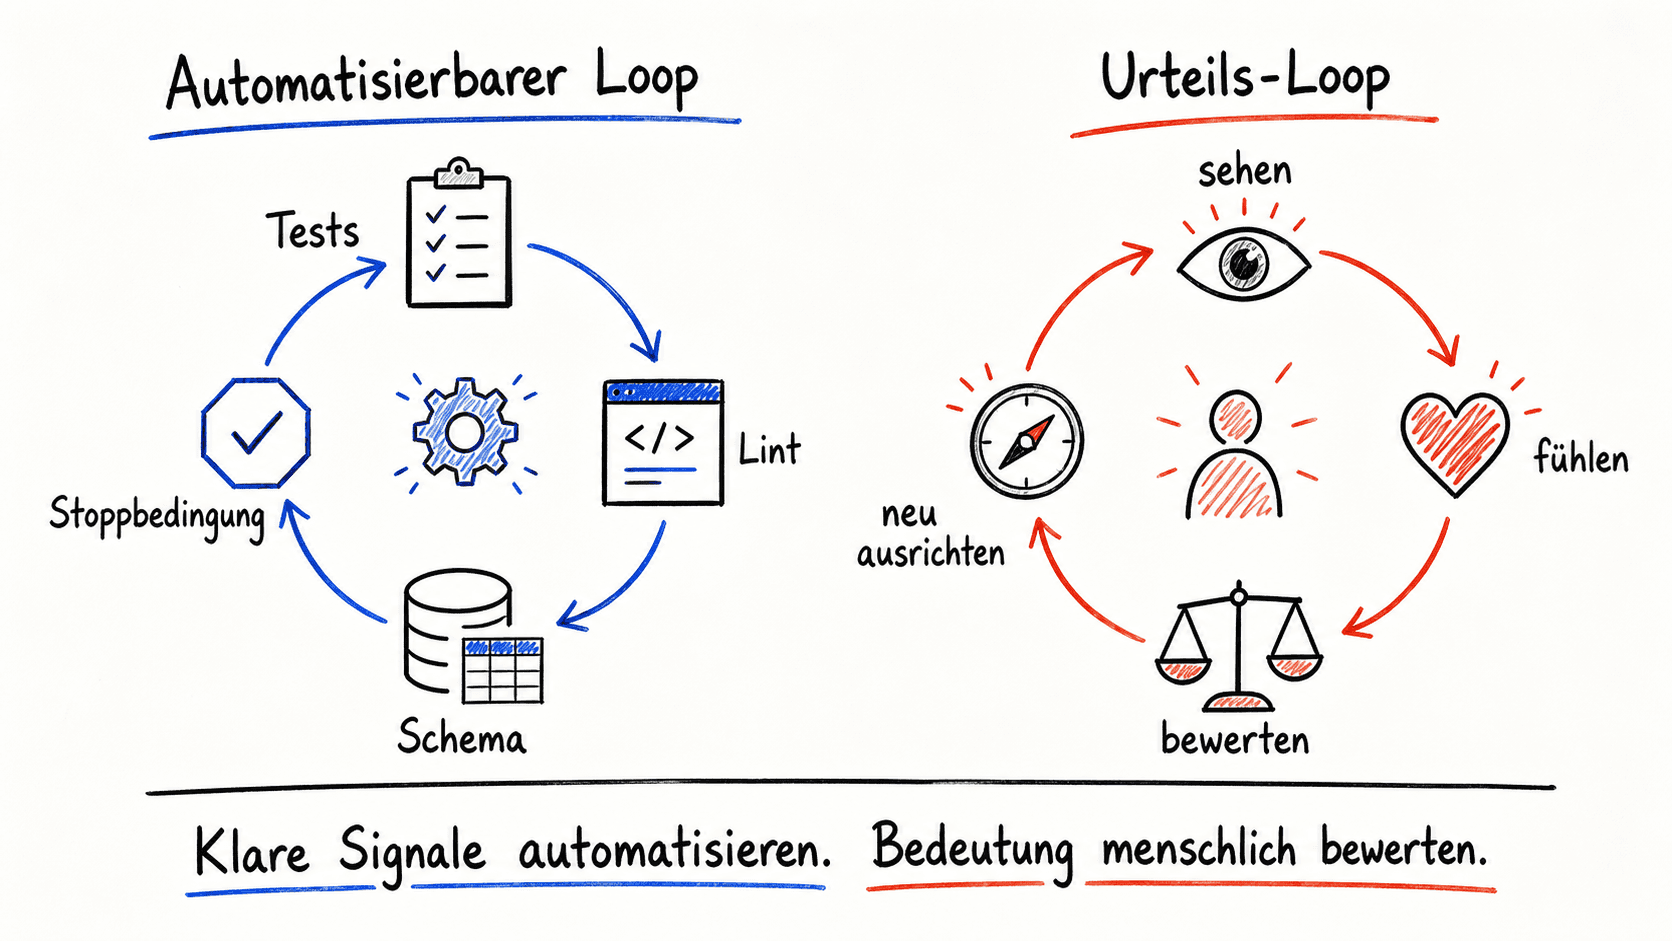
Wenn die Arbeit ein klares Ziel hat und das Bewertungssignal gut beschreibbar ist, kann eine automatisierte Schleife sehr stark sein. Tests sind ein gutes Beispiel. Linting auch. Broken Links. Formatchecks. Ein JSON-Schema. Ein Build, der entweder läuft oder nicht läuft. Ein Pull Request, der eine konkrete Fehlermeldung repariert.
Da darf eine Maschine gerne schleifen. Da soll sie sogar schleifen. Der Mensch muss nicht jede triviale Korrektur mit der Hand anfassen, wenn Ziel, Signal und Stoppbedingung klar genug sind.
Aber viele Arbeiten sind nicht so.
Wenn ich einen Text schreibe, ist "besser" nicht einfach ein Testresultat. Wenn ich ein Interface beurteile, ist "funktioniert" nicht nur ein grüner Build. Wenn ich eine Produktidee schärfe, ist der neue Zwischenstand nicht nur ein Output, sondern ein neuer Denkgegenstand. Ich sehe etwas. Ich reagiere darauf. Ich merke, dass ein Beispiel zu intern wirkt. Dass ein Begriff zu glatt ist. Dass eine Funktion zwar korrekt ist, aber an der eigentlichen Frage vorbeiläuft.
Das lässt sich nicht sauber in eine kleine Autopilot-Schleife pressen.
Wer bewertet den neuen Zustand?
Die eigentliche Designfrage lautet nicht: "Brauchen wir einen Loop?"
Die eigentliche Frage lautet: "Wer oder was bewertet den Zustand nach jeder Iteration?"
Manchmal ist die Antwort einfach:
- Ein Test.
- Ein Compiler.
- Ein Typecheck.
- Ein Evaluator.
- Eine Metrik.
- Ein Schema.
- Ein klarer Abgleich mit einer Anforderung.
Manchmal ist die Antwort: ein Mensch.
Nicht, weil der Mensch romantisch überlegen ist. Nicht, weil Automatisierung schlecht wäre. Sondern weil manche Entscheidungen Bedeutung tragen. Richtung. Geschmack. Verantwortung. Kontext. Produktgefühl. Nutzerwahrnehmung. All das, was in der Arbeit erst sichtbar wird, wenn ein Zwischenstand da ist.
Genau hier wird "human in the loop" oft falsch verstanden. Es klingt manchmal wie eine peinliche Reststelle: Da muss halt noch ein Mensch rein, weil die Automatisierung noch nicht weit genug ist.
Ich glaube, das ist zu kurz gedacht.
Der Mensch ist nicht nur ein Sicherheitsnetz am Ende. In vielen Arbeiten ist der Mensch die Instanz, die nach einem neuen Zwischenstand überhaupt erst sagen kann, was dieser Zwischenstand bedeutet.
Die entscheidende Gestaltungsfrage lautet nicht, ob das System eine Schleife durchläuft. Entscheidend ist, wer den neuen Zustand beurteilt.
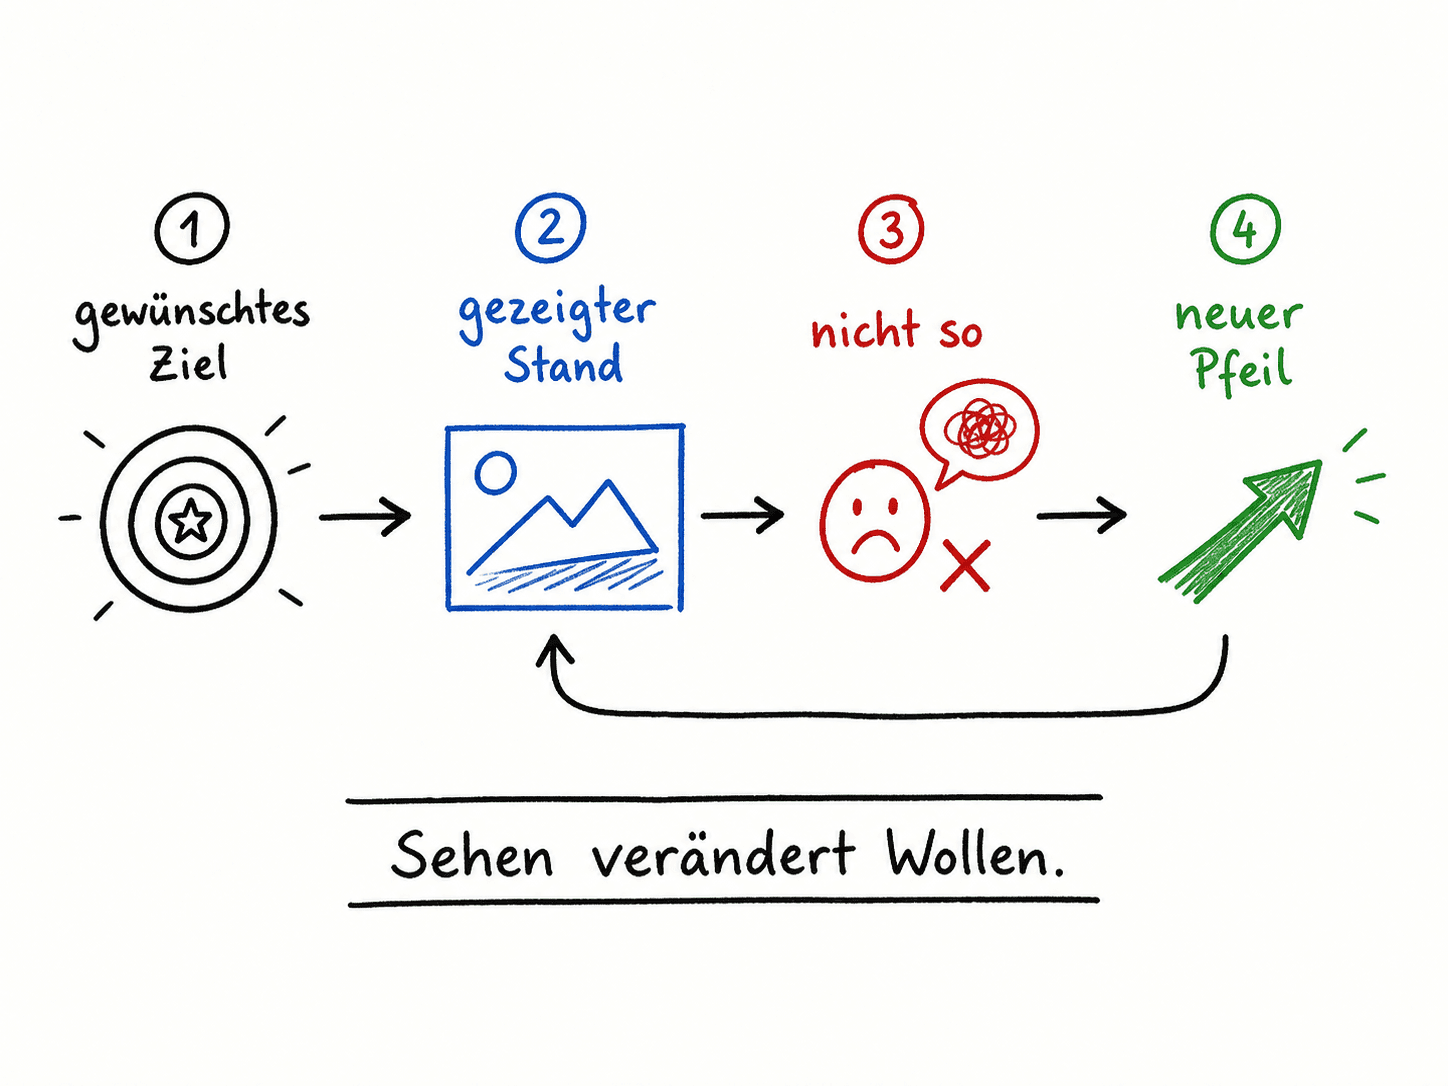
Das gilt besonders bei Produktarbeit. Ein Kunde weiß oft nicht exakt, was er will, bis er sieht, was gebaut wurde. Das ist kein Versagen des Kunden. Das ist normal. Wahrnehmung verändert Anforderungen. Ein sichtbarer Zwischenstand macht Unterschiede real, die vorher nur abstrakt waren.
Dasselbe passiert beim Schreiben. Beim Design. Bei Architektur. Bei Strategie. Bei Tools. Bei fast allem, wo "richtig" nicht vollständig vor der Arbeit bekannt ist.
Automatische Loops brauchen Grenzen
Automatisierte Loops sind stark, wenn sie Grenzen haben.
Automatische Loops brauchen:
- ein Ziel.
- ein Signal.
- eine Stoppbedingung.
- eine Vorstellung davon, was nicht optimiert werden soll.
Sonst erzeugen sie nur Bewegung.
Ein Agent, der eine Fehlermeldung repariert, kann sinnvoll laufen, bis der Test grün ist. Ein Agent, der eine Liste nach einem Schema normalisiert, kann sinnvoll laufen, bis alle Einträge passen. Ein Agent, der broken links findet, kann sinnvoll reparieren, bis keine kaputten Links mehr übrig sind.
Das ist langweilig im besten Sinne. Es ist klar. Es ist nützlich. Es spart Aufmerksamkeit.
Aber wenn ein Agent "mach den Artikel besser" bekommt, wird es schwieriger.
- Besser für wen?
- In welchem Ton?
- Mit welchem Risiko?
- Soll der Text schärfer werden oder ruhiger?
- Soll er persönlicher werden oder belastbarer?
- Soll er mehr Quellen zeigen oder weniger?
- Soll er einen Hype angreifen oder einordnen?
Ohne diese Bewertung wird der Loop nicht intelligent. Er wird nur aktiv.
Und Aktivität ist nicht dasselbe wie Fortschritt.
Human in the loop heißt nicht Mikromanagement
Der Gegenentwurf ist nicht, dass der Mensch wieder jeden kleinen Schritt selbst macht. Das wäre genauso falsch.
Ich will keine broken links von Hand reparieren, wenn ein Agent das zuverlässig kann. Ich will keine hundert Formatfehler einzeln anfassen. Ich will nicht jeden Boilerplate-Schritt selbst tippen. Wenn eine Schleife klar genug automatisierbar ist, soll sie automatisiert werden.
Der interessante Punkt liegt in der Arbeitsteilung. KI kann sehr schnell Zwischenstände erzeugen. Dadurch komme ich früher an die Stelle, an der es interessant wird. Ich kann sehen, ob eine Struktur trägt. Ich kann beurteilen, ob ein Beispiel funktioniert. Ich kann entscheiden, ob ein Bildmotiv die Denkbewegung wirklich sichtbar macht. Ich kann merken, ob ein Text nach mir klingt oder nach generischem AI-Content.
Das ist kein kleiner Unterschied. Früher war viel Aufmerksamkeit in Umsetzung gebunden. Heute entsteht schneller ein Zustand, auf den ich reagieren kann. Aber genau deshalb wird Urteil wichtiger.
KI macht Zwischenstände günstiger. Dadurch wird menschliches Urteilsvermögen wichtiger, nicht unwichtiger.
Wenn Zwischenergebnisse billiger werden, entstehen mehr davon. Mehr Varianten. Mehr Möglichkeiten. Mehr plausible Wege. Mehr Dinge, die irgendwie funktionieren könnten. Und damit auch mehr Entscheidungen darüber, welche Richtung trägt.
Loops lösen dieses Problem nicht automatisch. Sie verschieben es.
Ein brauchbarer Loop fragt nach Urteil
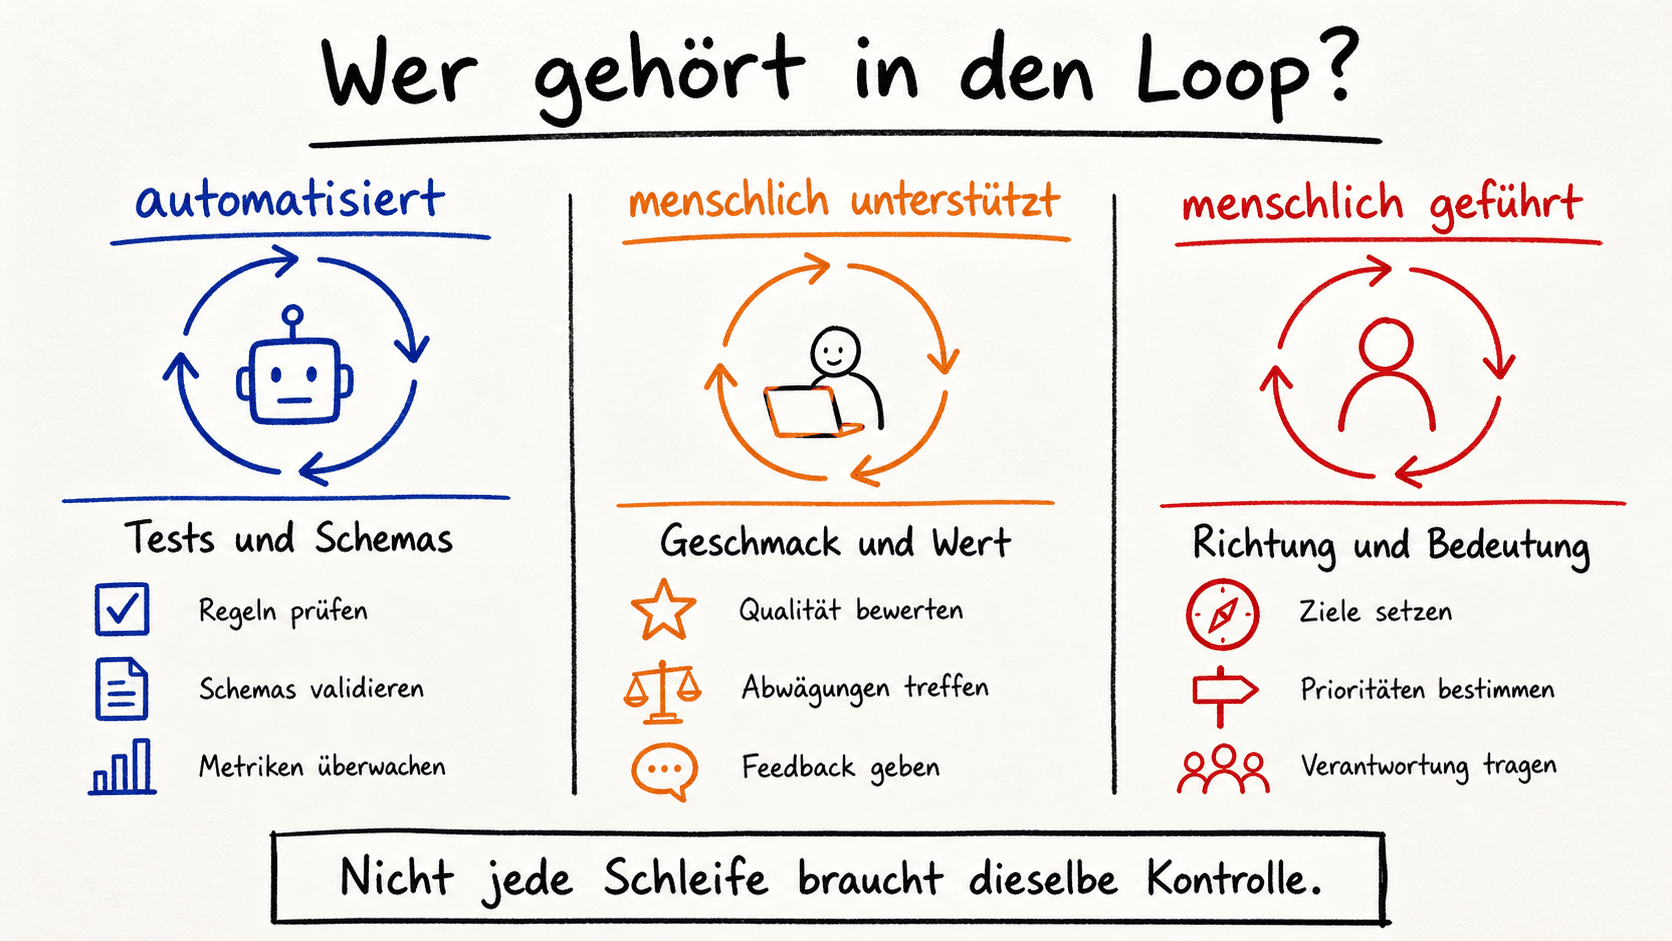
Vielleicht sollten wir über Loops weniger wie über Autonomie reden und mehr wie über Arbeitsdesign.
Nicht: Wie lasse ich den Agenten möglichst lange laufen?
Sondern:
- Was ist nach jedem Schritt neu bekannt?
- Welches Signal kann automatisiert bewertet werden?
- Welche Entscheidung braucht menschliches Urteil?
- Wann endet die Schleife?
- Was darf der Loop verändern?
- Was bleibt beim Menschen?
Das klingt weniger spektakulär als "100 agents running overnight". Es ist aber wahrscheinlich der nützlichere Teil.
Ein guter Loop ist kein magischer Kreis. Er ist eine bewusst gestaltete Rückkopplung. Manchmal automatisiert. Manchmal menschlich geführt. Oft gemischt.
Und vielleicht ist genau das der Unterschied zwischen Hype und Arbeit.
Der Hype sagt: Bau Loops.
Die Arbeit fragt: Welche Rückkopplung braucht dieser Kontext?
Schluss
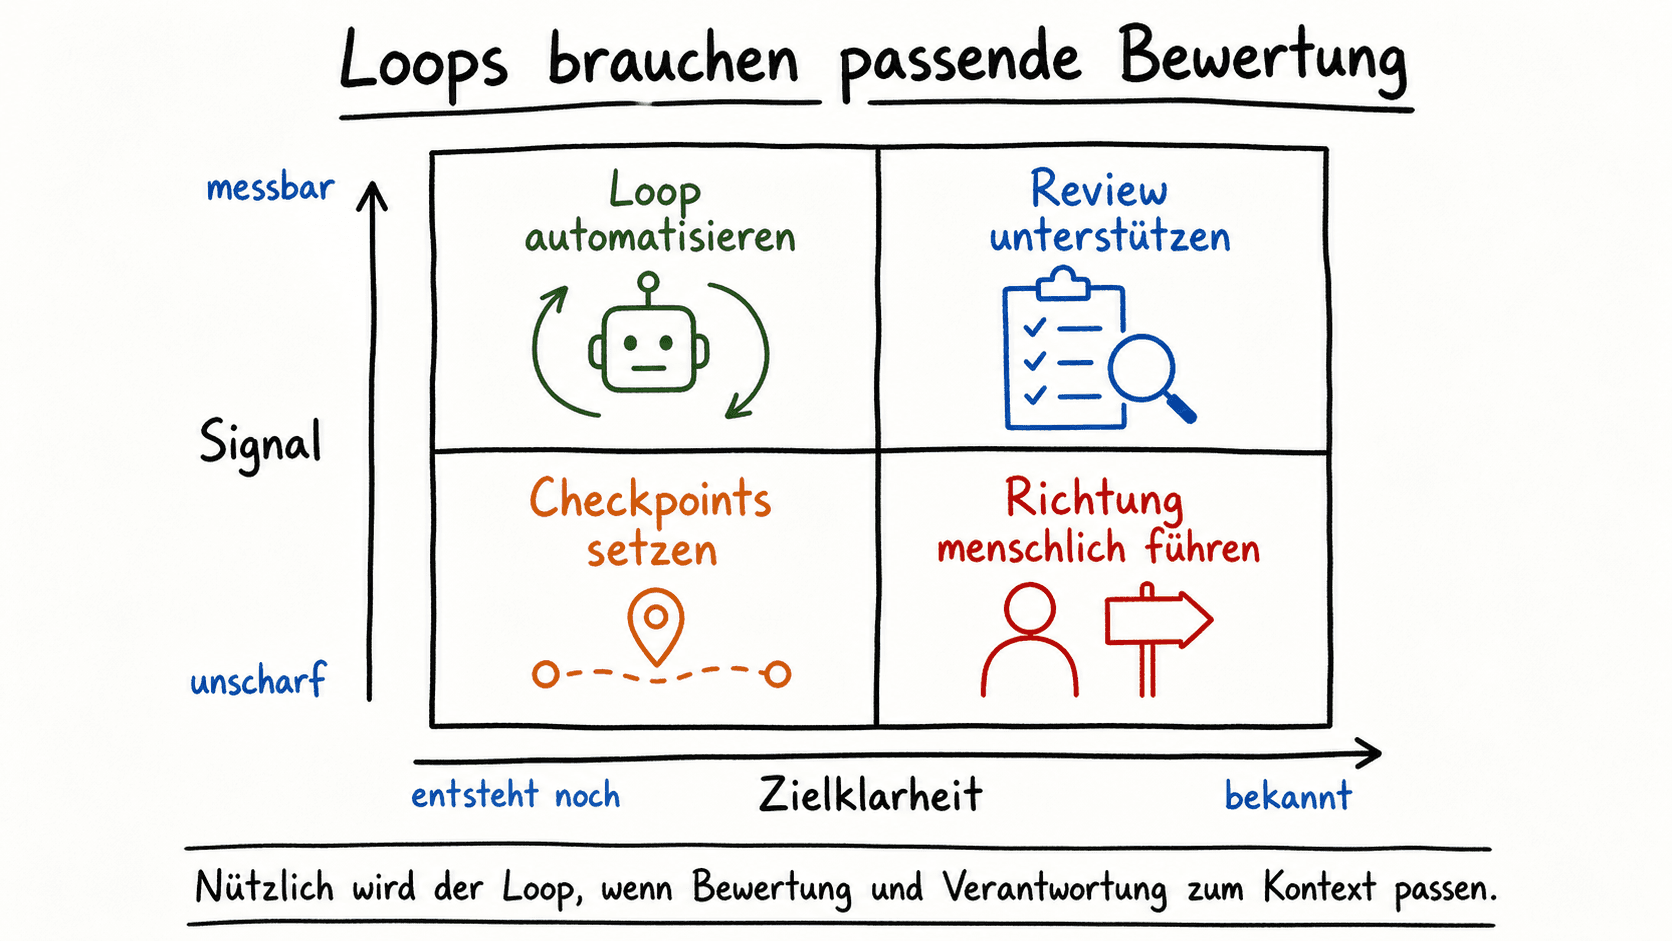
Ich glaube nicht, dass der aktuelle Loop-Hype komplett falsch ist. Im Gegenteil. Loops sind wichtig. Agenten werden durch Schleifen mächtiger. Viele Aufgaben werden davon profitieren, dass KI nicht nur einmal antwortet, sondern prüft, korrigiert und weiterarbeitet.
Aber ein Loop ist kein Perpetuum mobile. Er erzeugt keine Bedeutung aus sich selbst. Er ersetzt nicht die Frage, was gut ist. Er ersetzt nicht Richtung. Er ersetzt nicht Produkturteil. Er ersetzt nicht das unangenehme, notwendige Nachdenken nach einem neuen Zwischenstand.
Vielleicht ist das die nüchterne Version des Ganzen:
- Automatisiere die Schleife, wenn das Urteil klar genug beschrieben ist.
- Halte den Menschen in der Schleife, wenn der neue Zustand Bedeutung verändert.
- Und verkaufe Iteration nicht als neue Magie, nur weil jetzt ein Agent darin steckt.